

Crawlerele AI și robots.txt în 2026: Ce Boți Să Permiți pentru Vizibilitatea în Căutarea AI
 Catalin Dinca
Acum câțiva ani, robots.txt conta mai ales pentru Googlebot și Bingbot. Astăzi, un singur site poate fi vizitat de o duzină de boți de la OpenAI, Anthropic, Perplexity, Google și alții, iar nu toți fac același lucru. Unii construiesc indexurile din spatele răspunsurilor AI. Alții colectează conținut pentru antrenarea viitoarelor modele. Alții accesează o pagină doar pentru că un utilizator a întrebat un asistent despre ea.
Diferența contează. Dacă blochezi un crawler de căutare, paginile tale pot dispărea din răspunsurile AI ale acelei platforme. Dacă blochezi un crawler de antrenare, renunți la folosirea conținutului pentru antrenarea viitoarelor modele, de obicei fără efect asupra vizibilității în căutare. Multe site-uri greșesc în ambele direcții: blochează tot ce e „AI” și pierd vizibilitate sau nu verifică niciodată și descoperă că CDN-ul le-a blocat boții AI de luni de zile.
Ghidul explică ce face fiecare crawler AI important, cum se aplică robots.txt conform documentației fiecărei companii și cum alegi configurarea potrivită obiectivelor tale.
TL;DR
- Boții AI au trei roluri diferite: indexare pentru căutare (de exemplu OAI-SearchBot, Claude-SearchBot, PerplexityBot), antrenarea modelelor (GPTBot, ClaudeBot, Google-Extended, CCBot) și accesare la cererea utilizatorului (ChatGPT-User, Claude-User, Perplexity-User).
- Permite crawlerele de căutare dacă vrei vizibilitate în AI. OpenAI spune că site-urile care blochează OAI-SearchBot nu vor apărea în răspunsurile de căutare ChatGPT, deși pot apărea în continuare ca linkuri de navigare.
- Blocarea boților de antrenare este o decizie de business, nu o cerință SEO. Google-Extended, de exemplu, nu afectează Google Search, AI Overviews sau AI Mode.
- Verifică CDN-ul și firewall-ul, nu doar robots.txt. Regulile de protecție împotriva boților pot bloca crawlerele AI chiar dacă robots.txt le permite.
- Nu te aștepta ca llms.txt să rezolve ceva în Google. Google spune că ignoră fișierele text pentru AI și markup-ul special în Search.
- Măsoară după fiecare modificare: urmărește mențiunile și citările în AI, plus rapoartele AI Performance din Bing și Generative AI din Search Console.
Cuprins
- De Ce Contează robots.txt pentru Vizibilitatea în AI
- Cele Trei Tipuri de Boți AI
- Tabel de Referință cu Crawlerele AI
- Pasul 1: Decide Ce Vrei
- Pasul 2: Verifică robots.txt-ul Actual
- Pasul 3: Alege o Configurare robots.txt
- Pasul 4: Verifică CDN-ul, Firewall-ul și Hostingul
- Pasul 5: Verifică Crawlerele în Logurile Serverului
- Pasul 6: Nu Investi Prea Mult în llms.txt
- Pasul 7: Măsoară Efectul
- Greșeli Frecvente
- Cum Te Ajută Rank Tim
- Întrebări Frecvente
- Surse
- Articole Recomandate
De Ce Contează robots.txt pentru Vizibilitatea în AI
Asistenții AI care caută pe web au nevoie de două lucruri ca să-ți citeze pagina: să aibă voie să o acceseze și să o poată citi. robots.txt este prima barieră.
Fiecare companie AI își publică propriii boți și explică cum respectă robots.txt. Regulile nu sunt identice de la o companie la alta, de aceea o singură regulă de tip „blochează AI” poate avea efecte nedorite. De exemplu, OpenAI precizează că fiecare setare robots.txt este independentă: poți permite OAI-SearchBot pentru căutare și bloca GPTBot pentru antrenare.
La Google situația e diferită. AI Overviews și AI Mode fac parte din Google Search, așa că sunt controlate de Googlebot și de setările obișnuite pentru fragmente, nu de un crawler AI separat. Ghidul nostru despre cum ajungi citat în Google AI Overviews și AI Mode tratează în detaliu această parte.
Cele Trei Tipuri de Boți AI
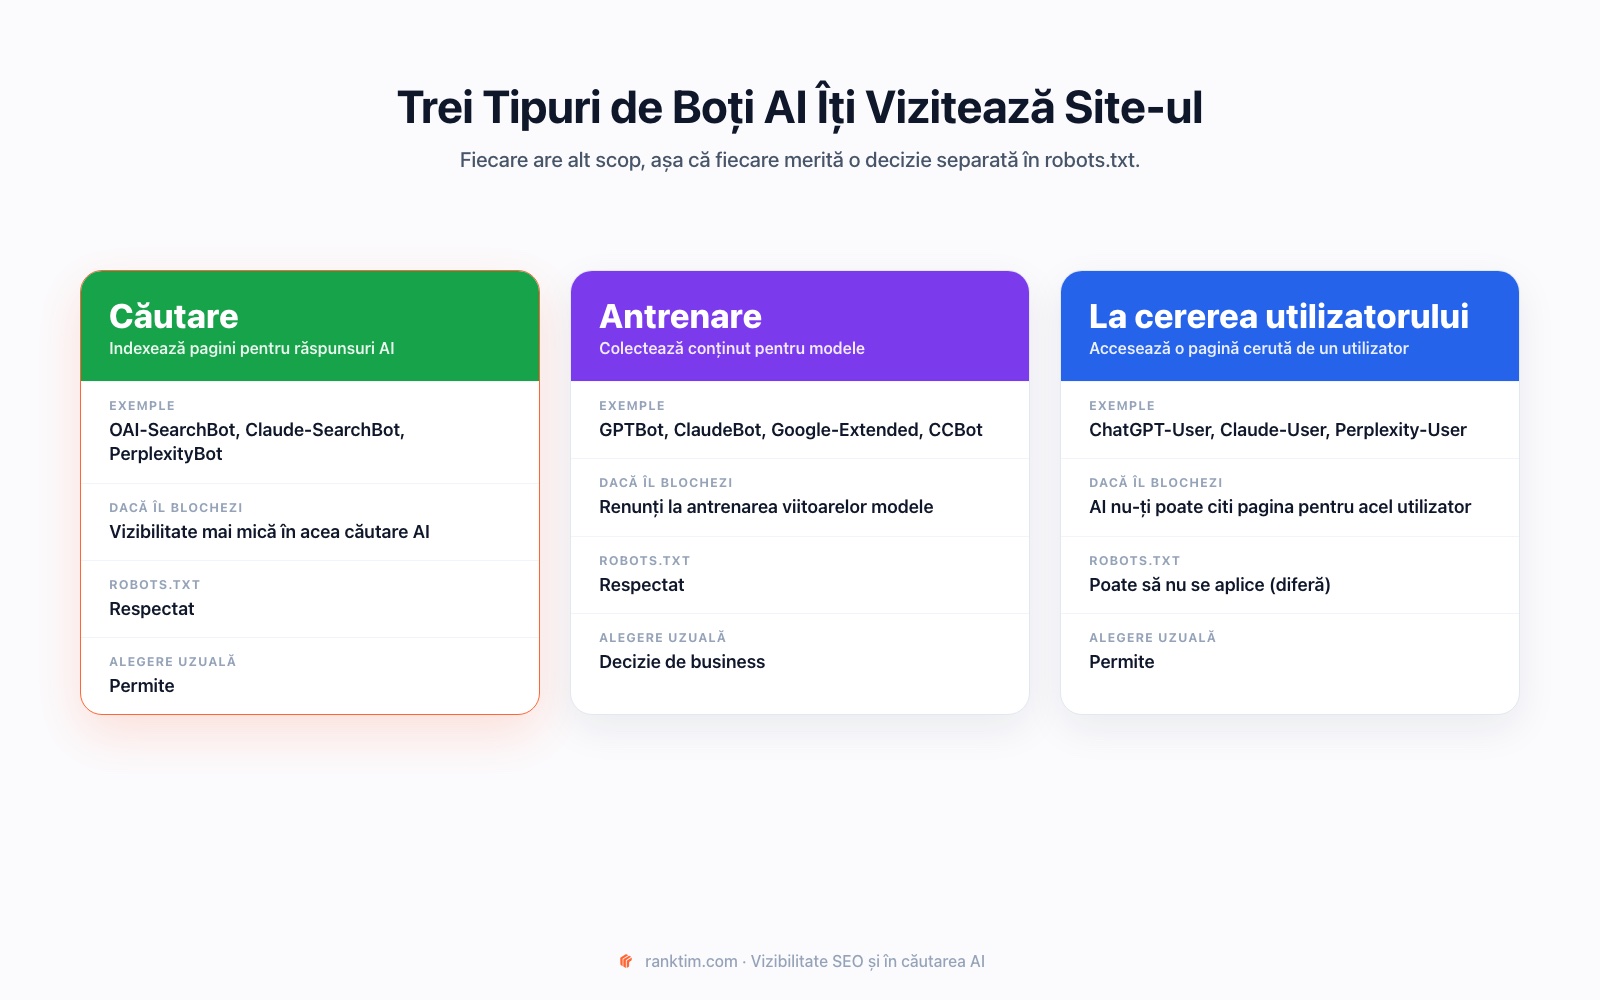
- Crawlerele de căutare construiesc indexul în care caută un asistent AI când răspunde la întrebări. Dacă le blochezi, scade vizibilitatea ta în răspunsurile acelui asistent.
- Crawlerele de antrenare colectează conținut public care poate fi folosit la antrenarea viitoarelor modele. Dacă le blochezi, semnalezi că nu vrei ca conținutul tău să fie folosit pentru antrenare.
- Boții care acționează la cererea utilizatorului vizitează o pagină pentru că un utilizator i-a cerut asistentului s-o citească sau s-o rezume. Unele companii spun că robots.txt poate să nu se aplice acestora, deoarece cererea vine de la o persoană.
Tabel de Referință cu Crawlerele AI
Tabelul rezumă ce documentează fiecare companie despre principalii săi boți. Verifică mereu paginile oficiale din secțiunea Surse, pentru că se schimbă în timp.
| Companie | User agent | Ce face | robots.txt |
|---|---|---|---|
| OpenAI | OAI-SearchBot | Afișează site-uri în funcțiile de căutare ChatGPT | Respectat. Schimbările pot dura aproximativ 24 de ore pentru căutare |
| OpenAI | GPTBot | Accesează conținut care poate fi folosit la antrenarea modelelor | Respectat |
| OpenAI | ChatGPT-User | Vizitează pagini pentru acțiunile utilizatorilor în ChatGPT și Custom GPTs | Poate să nu se aplice, fiind inițiat de utilizator |
| OpenAI | OAI-AdsBot | Verifică siguranța paginilor trimise ca reclame în ChatGPT | Vizitează doar paginile de destinație ale reclamelor |
| Anthropic | ClaudeBot | Colectează conținut care poate contribui la antrenarea modelelor | Respectat, inclusiv Crawl-delay |
| Anthropic | Claude-SearchBot | Îmbunătățește calitatea rezultatelor de căutare Claude | Respectat |
| Anthropic | Claude-User | Accesează pagini când utilizatorii îi pun întrebări lui Claude | Respectat, potrivit Anthropic |
| Perplexity | PerplexityBot | Afișează și leagă site-uri în căutarea Perplexity; nu e folosit pentru antrenare | Se gestionează prin robots.txt |
| Perplexity | Perplexity-User | Vizitează pagini ca să răspundă la întrebarea unui utilizator | În general ignoră robots.txt |
| Googlebot | Accesează paginile pentru Google Search, inclusiv AI Overviews și AI Mode | Respectat | |
| Google-Extended | Un token de control pentru antrenarea și grounding-ul Gemini în Gemini Apps și Vertex AI; fără crawler separat | Respectat; nu afectează Google Search | |
| Common Crawl | CCBot | Construiește o arhivă deschisă a webului, folosită de mulți dezvoltatori AI | Respectat |
Experiențele AI ale Microsoft, precum Copilot și rezumatele AI din Bing, se bazează pe Bing. În anunțul raportului AI Performance, Microsoft spune că Bing respectă toate preferințele proprietarilor de conținut exprimate prin robots.txt și prin alte mecanisme de control acceptate, așa că păstrează Bingbot permis dacă vrei vizibilitate acolo.
Pasul 1: Decide Ce Vrei
Înainte să modifici ceva, răspunde la două întrebări:
- Vrei să apari în răspunsurile AI și în căutarea AI? Pentru majoritatea firmelor, răspunsul este da. Recomandările din ChatGPT, Claude sau Perplexity sunt un nou canal de descoperire. Permite crawlerele de căutare și boții care acționează la cererea utilizatorilor.
- Ești de acord ca, în viitor, conținutul tău să fie folosit pentru antrenarea modelelor? Este o decizie de business și juridică. Publisherii care vând conținut blochează adesea boții de antrenare; multe companii îi permit, pentru că o reprezentare bună în modele ajută brandul.
Cele două decizii sunt independente. Poți fi complet vizibil în căutarea AI și totuși să refuzi antrenarea.
Pasul 2: Verifică robots.txt-ul Actual
Deschide domeniultau.ro/robots.txt și caută:
- un
User-agent: *general cuDisallow: /, rămas de pe un site de test - grupuri care blochează anumiți boți AI, adăugate uneori de pluginuri sau de o agenție anterioară
- nume de user agent vechi, scrise greșit sau depășite
- lipsa unui rând
Sitemap:
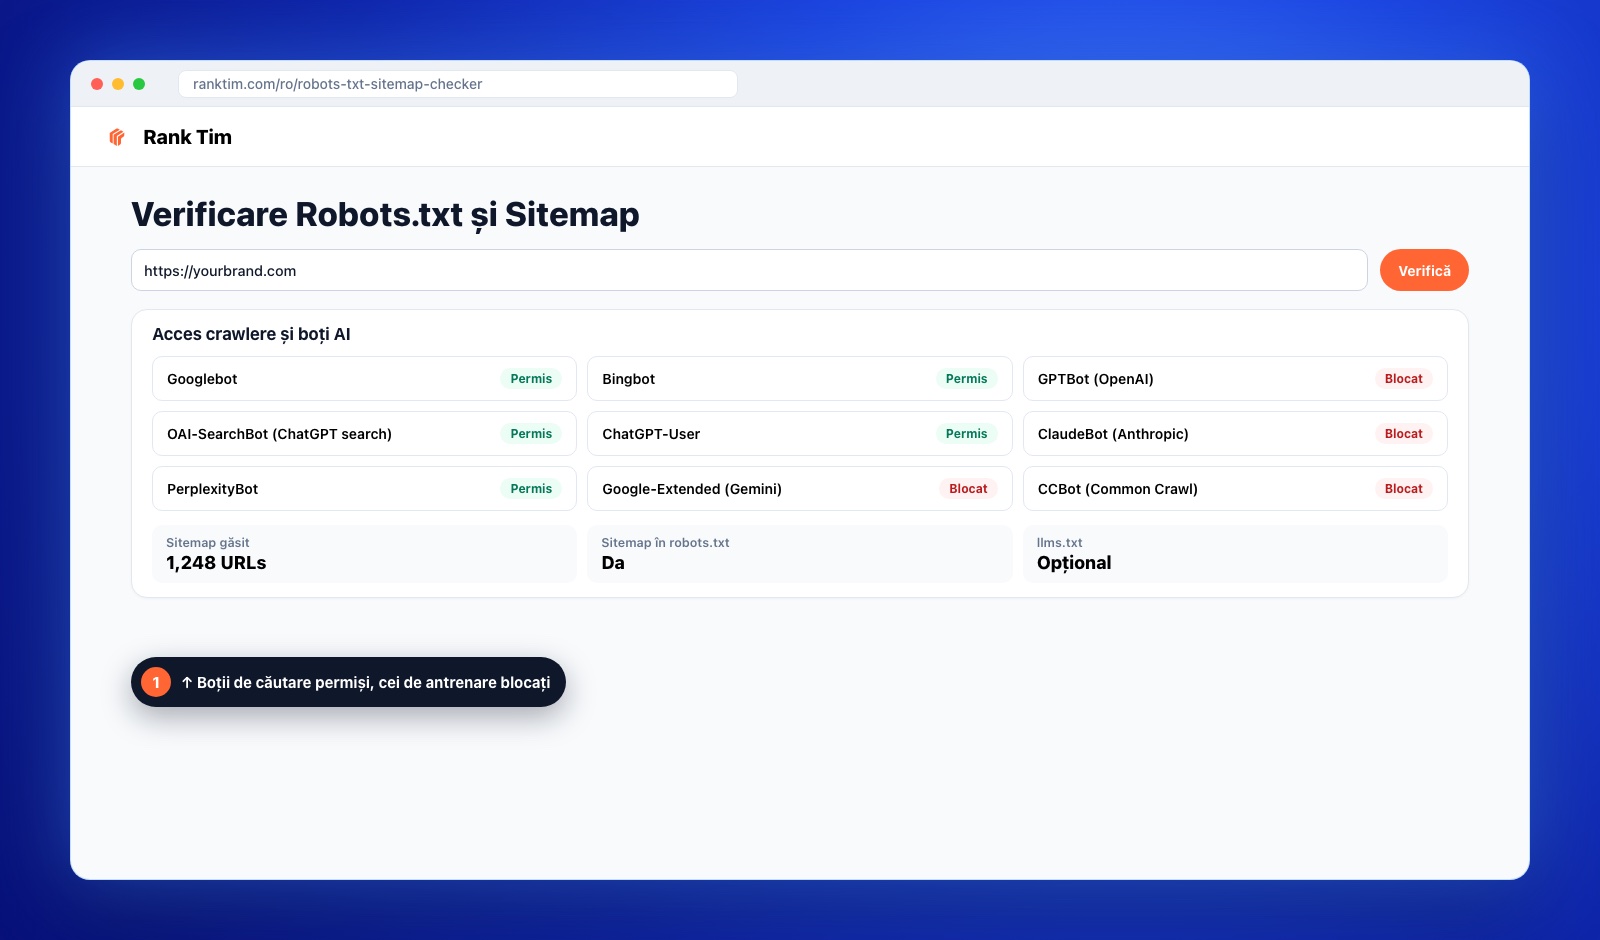
O variantă mai rapidă este instrumentul gratuit Verificare Robots.txt și Sitemap. Îți citește fișierul, îți arată bot cu bot dacă fiecare crawler are acces și îți verifică totodată sitemap-ul.
Pasul 3: Alege o Configurare robots.txt
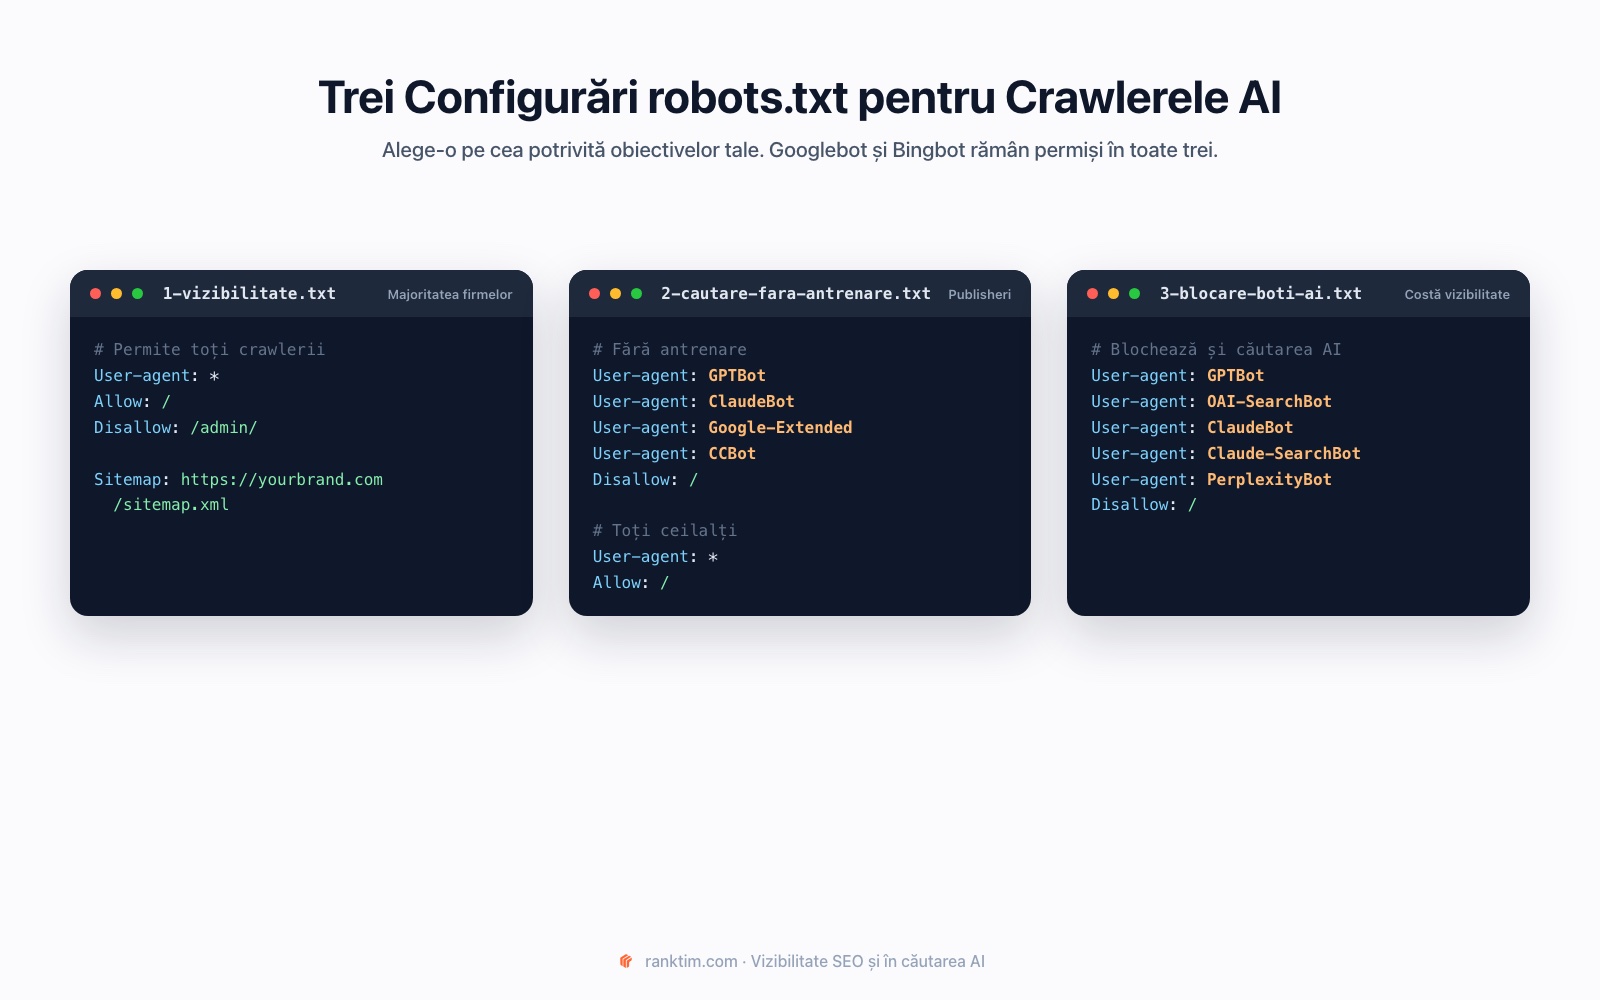
Majoritatea site-urilor se încadrează într-una din trei configurări. În toate, Googlebot și Bingbot rămân permiși.
Configurarea 1: Vizibilitate maximă
Pentru majoritatea firmelor care vor să fie găsite și recomandate:
User-agent: *
Allow: /
Disallow: /admin/

Sitemap: https://brandultau.ro/sitemap.xml
Configurarea 2: Căutare AI da, antrenare nu
Pentru publisheri și branduri care vor vizibilitate în AI, dar nu și folosirea conținutului la antrenare:
# Fără antrenarea modelelor
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: CCBot
Disallow: /

# Crawlerele de căutare și toți ceilalți
User-agent: *
Allow: /

Sitemap: https://brandultau.ro/sitemap.xml
Configurarea 3: Blocarea boților AI
Doar dacă accepți să pierzi vizibilitatea în căutarea AI:
User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Disallow: /Pasul 4: Verifică CDN-ul, Firewall-ul și Hostingul
robots.txt este o cerere, nu un lacăt. Și problema inversă este frecventă: robots.txt permite crawlerele AI, dar infrastructura le blochează.
- Reguli CDN și WAF: multe CDN-uri și servicii de securitate oferă setări de tip „blochează boții AI” dintr-un singur click. Verifică dacă sunt active și dacă se potrivesc cu decizia ta din robots.txt.
- Limitarea ratei: limitele prea agresive pot returna erori crawlerelor legitime.
- Login și blocare geografică: conținutul din spatele lor este invizibil pentru boți.
- Conținut doar prin JavaScript: dacă textul principal apare doar după rularea scripturilor, unele crawlere pot vedea o pagină goală. Ghidul nostru despre cum optimizezi site-ul pentru căutarea AI tratează în detaliu randarea.
Verifică gratuit ce boți îți pot accesa site-ul
Instrumentul Rank Tim Verificare Robots.txt și Sitemap îți citește fișierul robots.txt și îți arată, bot cu bot, dacă Googlebot, Bingbot, GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot, Google-Extended și CCBot au acces.
Verifică robots.txtPasul 5: Verifică Crawlerele în Logurile Serverului
User agentul poate fi falsificat. Ca să confirmi că o vizită vine cu adevărat de la o companie AI, compară adresa IP cu intervalele publicate de companii:
- OpenAI publică liste separate de IP-uri pentru OAI-SearchBot, GPTBot și ChatGPT-User.
- Anthropic publică lista IP-urilor crawlerelor sale.
- Perplexity publică intervalele IP pentru PerplexityBot și Perplexity-User.
Uită-te în loguri la cererile fiecărui bot, la codurile de răspuns pe care le primesc și la paginile pe care le cer. Un crawler care primește doar răspunsuri 403 sau 429 este practic blocat, indiferent ce spune robots.txt.
Pasul 6: Nu Investi Prea Mult în llms.txt
Un fișier llms.txt oferă instrumentelor AI un ghid text al site-ului tău. Unele instrumente îl pot folosi, dar nu este un standard pe care să se bazeze marile platforme de căutare. Google este explicit: nu ai nevoie de fișiere text pentru AI, markup special sau versiuni Markdown ale paginilor ca să apari în Google Search, iar Google Search le ignoră.
Dacă ai deja unul, ține-l corect. Dacă nu ai, rezolvă mai întâi accesul crawlerelor, indexarea și calitatea conținutului.
Pasul 7: Măsoară Efectul
După orice modificare, verifică dacă se mișcă vizibilitatea:
- Răspunsurile AI: urmărește un set fix de prompturi și vezi dacă brandul tău este menționat și paginile tale citate.
- AI Performance din Bing Webmaster Tools: arată citările paginilor tale în Copilot, în rezumatele AI din Bing și în unele experiențe ale partenerilor.
- Search Console: raportul Generative AI performance arată afișările în AI Overviews și AI Mode.
- GA4: canalul AI Assistant arată vizitele din asistenți precum ChatGPT, Gemini și Copilot.
Ghidul nostru complementar despre cum măsori vizibilitatea în căutarea AI arată cum combini aceste surse într-un raport lunar.
Greșeli Frecvente
- Blochezi OAI-SearchBot când voiai să blochezi GPTBot. Pierzi vizibilitatea în căutarea ChatGPT fără să câștigi nimic.
- Presupui că Google-Extended controlează AI Overviews. Nu o face; AI Overviews și AI Mode depind de Googlebot și de setările pentru fragmente.
- Uiți de subdomenii. Fiecare subdomeniu are nevoie de propriul robots.txt.
- Lași regulile de test în producție. Un singur
Disallow: /poate ascunde tot site-ul. - Nu mai verifici niciodată. Actualizările CMS, pluginurile și schimbările de CDN pot modifica accesul fără să observi.
Cum Te Ajută Rank Tim
Accesul crawlerelor este prima verigă dintr-un lanț: acces, indexare, conținut care merită citat, apoi măsurare. Rank Tim acoperă fiecare verigă:
- Verificare Robots.txt și Sitemap, gratuit: îți arată bot cu bot dacă Googlebot, Bingbot, GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot, Google-Extended și CCBot îți pot accesa site-ul și îți validează sitemap-ul. Încearcă aici.
- Audit AEO: în Audit site, verifică semnalele de descoperire precum robots.txt, sitemap-urile și llms.txt, plus datele structurate, calitatea conținutului, sănătatea tehnică și randarea pe server.
- Monitorizarea vizibilității în AI: îți rulează prompturile în ChatGPT, Google AI Mode, Gemini, Perplexity, Copilot și Grok, ca să vezi dacă o modificare în robots.txt aduce mai multe mențiuni și citări.
Instrumentul gratuit îți dă un răspuns rapid; platforma completă îți arată dacă accesul se transformă în vizibilitate. Poți începe și cu un audit gratuit de vizibilitate AI.
Întrebări Frecvente
Ar trebui să blochez GPTBot?
Doar dacă nu vrei ca, în viitor, conținutul tău să fie folosit la antrenarea modelelor OpenAI. Blocarea GPTBot nu te scoate din căutarea ChatGPT; aceasta depinde de OAI-SearchBot, pe care OpenAI îl tratează ca pe o setare separată.
Care este diferența dintre GPTBot și OAI-SearchBot?
GPTBot accesează conținut care poate fi folosit la antrenarea modelelor OpenAI. OAI-SearchBot afișează site-uri în funcțiile de căutare ChatGPT. OpenAI spune că setările sunt independente, deci poți permite unul și bloca celălalt.
Dacă blochez Google-Extended, dispare site-ul meu din AI Overviews?
Nu. Google precizează că Google-Extended nu influențează includerea sau clasarea în Google Search. AI Overviews și AI Mode fac parte din Search și sunt controlate de Googlebot și de setările pentru fragmente, precum nosnippet.
Respectă crawlerele AI robots.txt?
Principalele crawlere de căutare și de antrenare de la OpenAI, Anthropic, Perplexity și Google documentează că respectă robots.txt. Boții care acționează la cererea utilizatorilor sunt diferiți: OpenAI spune că regulile robots.txt pot să nu se aplice pentru ChatGPT-User, iar Perplexity spune că Perplexity-User le ignoră în general.
În cât timp își face efectul o modificare în robots.txt?
Depinde de crawler. OpenAI spune că pot trece aproximativ 24 de ore până când căutarea ChatGPT reflectă o actualizare a robots.txt. Alte sisteme reaccesează site-urile după propriul program, așa că verifică din nou după câteva zile.
Am nevoie de un fișier llms.txt ca să apar în căutarea AI?
Nu. Google spune că ignoră fișierele text pentru AI în Search. Unele instrumente pot citi llms.txt, dar accesul crawlerelor, indexarea și conținutul util contează mult mai mult.
Ce crawlere AI ar trebui să permită un magazin online?
Majoritatea magazinelor au de câștigat dacă permit crawlerele de căutare și boții care acționează la cererea utilizatorilor, pentru că tot mai mulți cumpărători cer recomandări de produse asistenților AI. Permiterea crawlerelor de antrenare este o decizie separată.
Surse
- OpenAI: Overview of OpenAI crawlers
- Anthropic: Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Perplexity: Perplexity crawlers
- Google Search Central: Google's common crawlers (Google-Extended)
- Google Search Central: Optimizing for generative AI features on Google Search
- Google Search Central: AI features and your website
- Microsoft Bing: Introducing AI Performance in Bing Webmaster Tools
Articole Recomandate
- Cum Măsori Vizibilitatea în Căutarea AI: Search Console, Bing AI Performance și GA4
- Cum Alegi un Instrument de Vizibilitate AI: 12 Criterii și o Fișă de Evaluare
- Cum Optimizezi Site-ul pentru Căutarea AI
- Ce Este GEO? Generative Engine Optimization pe Înțeles
- Cum Ajungi Citat în Google AI Overviews și AI Mode
Asigură-te că AI Te Poate Găsi, Apoi Măsoară
Verifică accesul crawlerelor, repară ce blochează căutarea AI și urmărește cum te menționează și te citează ChatGPT, Google AI, Gemini, Perplexity și Copilot.
Începe Gratuit
Catalin Dinca
Scris de Catalin Dinca